Resuma este artigo com:
O cache do Google nasceu nos primeiros anos do buscador, há mais de duas décadas, para que as pessoas pudessem ler uma página mesmo quando o site estava fora do ar ou demorava demais para carregar.
No entanto, em fevereiro de 2024 o Google retirou o link do cache que aparecia ao lado de cada resultado e, meses depois, desativou também o operador cache.
Segundo o próprio Google, a decisão se deve ao fato de o recurso ter sido criado quando a web era muito menos confiável, e essa necessidade praticamente desapareceu com a infraestrutura atual.
Mesmo assim, o fim das páginas em cache do Google não significa que você não possa mais ver como uma página era antes, já que existem métodos alternativos que funcionam tanto no próprio Google quanto em outros buscadores e ferramentas externas.
O que era o cache do Google e por que ele desapareceu?
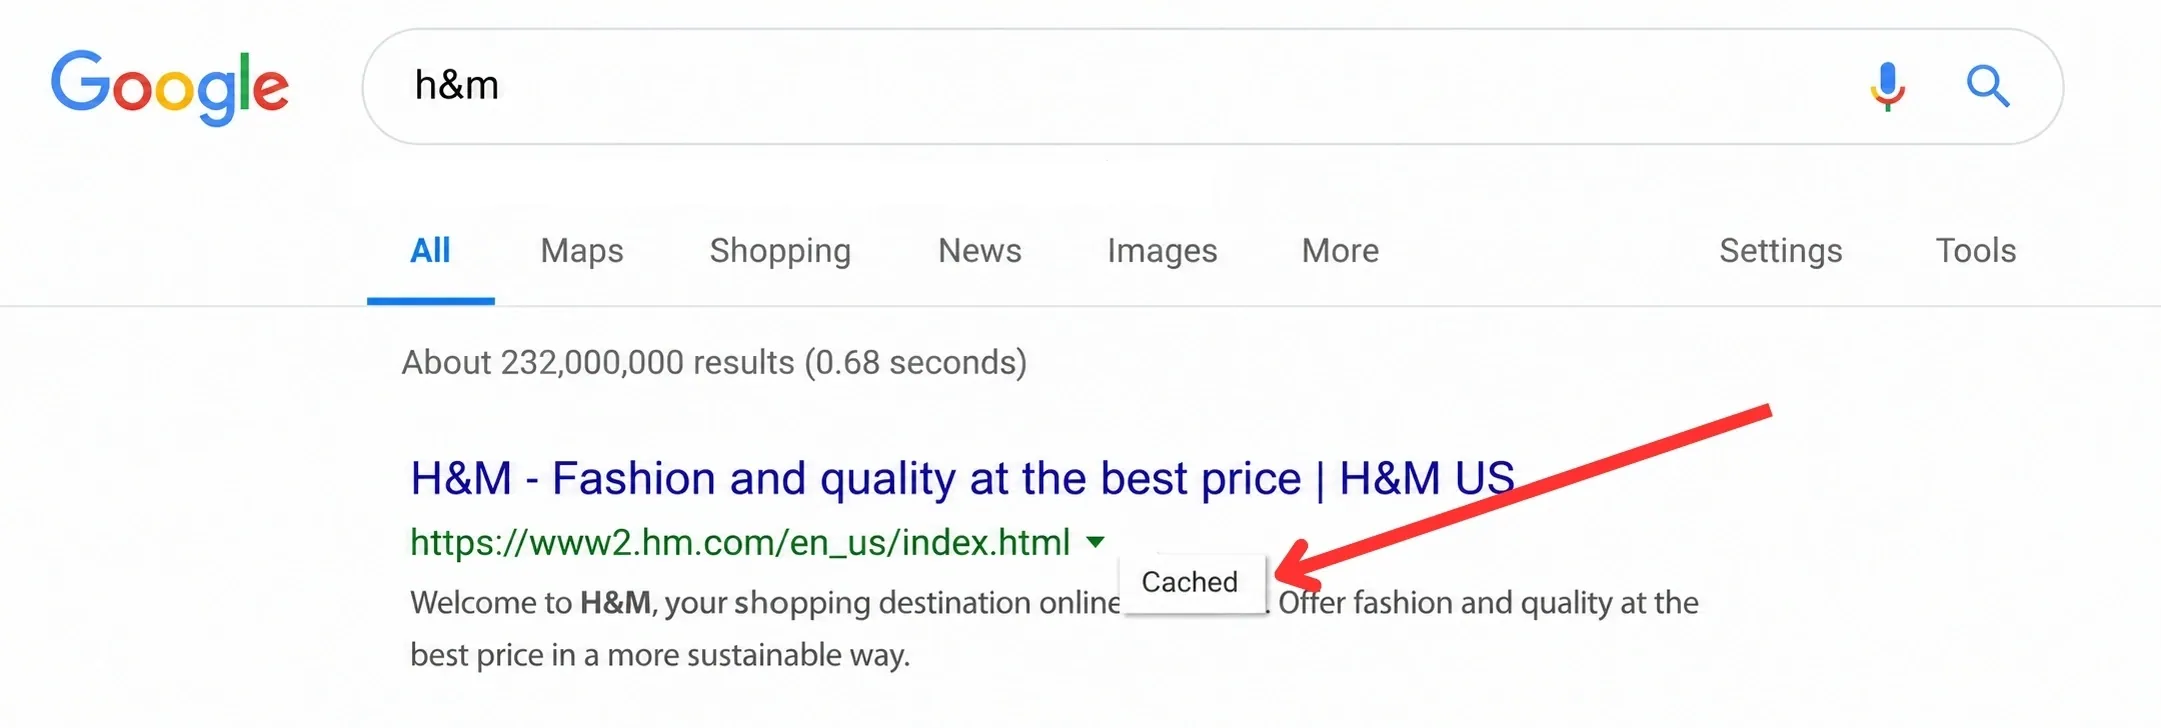
As páginas armazenadas em “cache” eram uma cópia do site exatamente como o Google o viu na última vez que rastreou a página. Ao clicar no link, você via essa versão salva em vez da página ao vivo.
Esse recurso servia para várias coisas ao mesmo tempo:
- Abrir um site que estava fora do ar ou demorava demais para carregar.
- Comparar o que uma página dizia antes e depois de uma edição.
- Verificar como o Google interpretava o conteúdo de uma URL.
- Preservar provas de um conteúdo que depois foi apagado.
Por isso, era uma ferramenta comum entre jornalistas, advogados e profissionais, muito além do uso técnico para o qual foi criada.
Por que o Google removeu o cache?
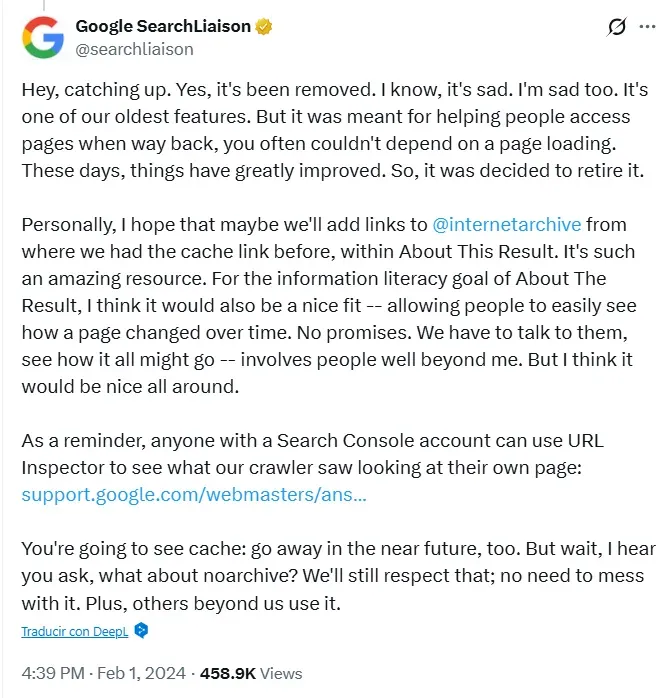
O Google confirmou a retirada em 1º de fevereiro de 2024, e explicou que o recurso foi criado quando as páginas muitas vezes não carregavam, uma necessidade que já não existe com a infraestrutura atual.
Primeiro, o link sumiu dos resultados de busca e, meses depois, em setembro de 2024, o operador cache deixou de funcionar por completo, por isso já não há nenhuma forma de abrir a cópia original dentro do buscador.
Como ver páginas antigas pelo próprio Google?
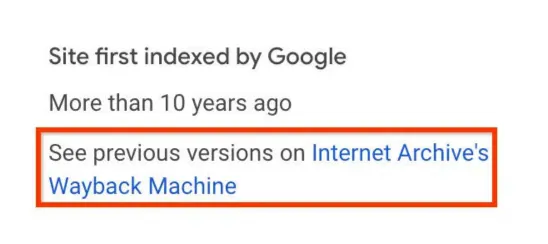
Em 11 de setembro de 2024, o Google adicionou links para o arquivo Wayback Machine no painel de informações de cada resultado.
Esse link não está mais disponível: uma reformulação do painel eliminou a seção que o abrigava, e o Google não publicou nenhum esclarecimento sobre a mudança.
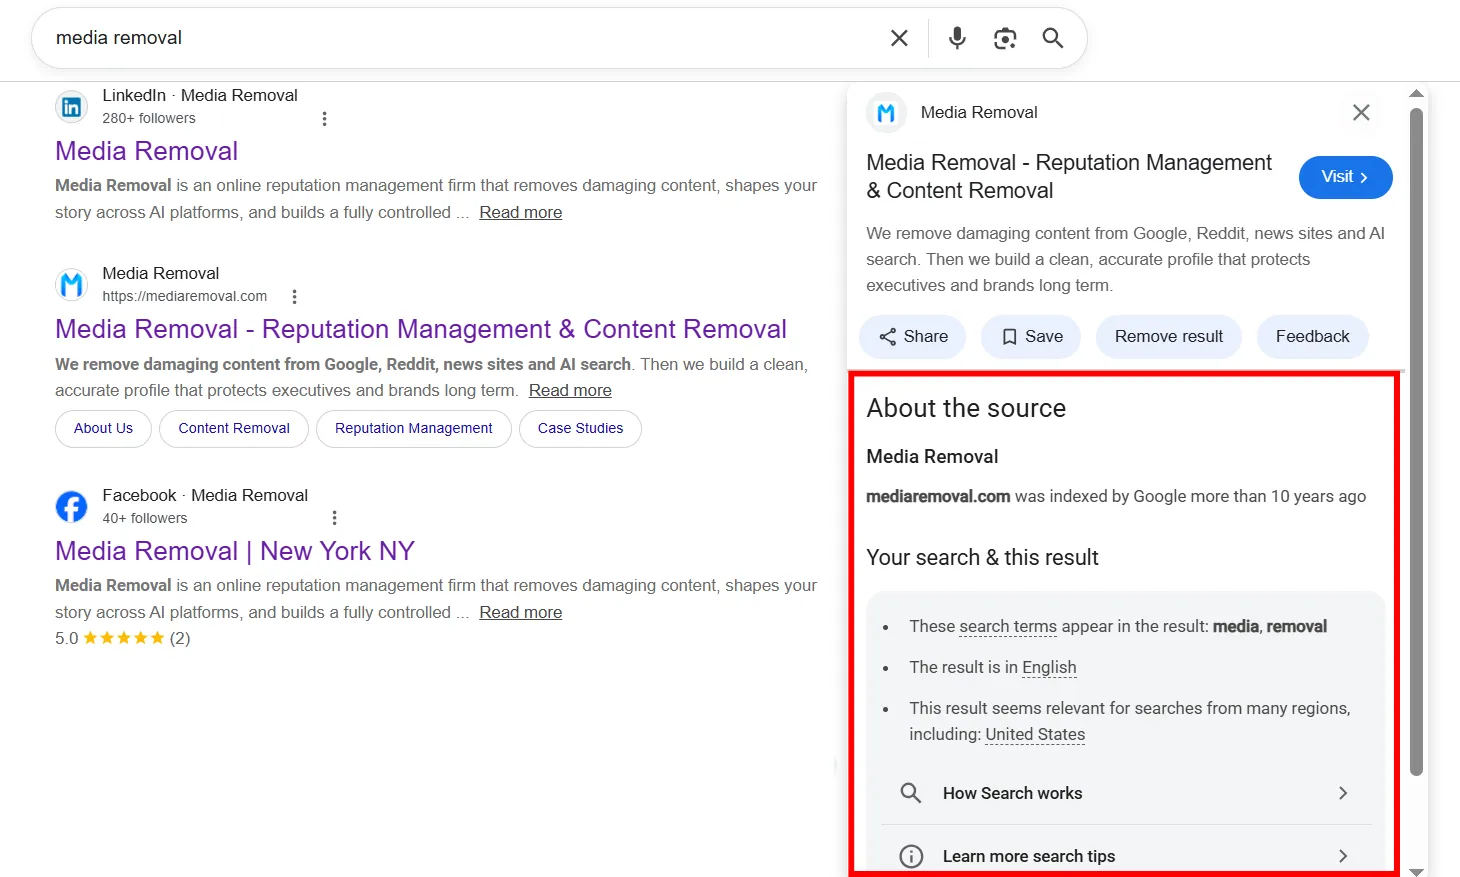
Hoje, a única forma de ver versões anteriores de uma página é acessar diretamente o Wayback Machine ou usar ferramentas externas.
Por outro lado, se o site for seu, você pode inspecionar a URL no Google Search Console, que mostra o HTML rastreado e o registro que o Google tem da sua própria página, algo especialmente útil para confirmar se uma alteração já foi processada.
Alternativas externas para consultar versões anteriores
Quando você não encontra a versão em cache de uma URL no Google, arquivos independentes podem ter salvado uma cópia desse site.
Estas são as opções que funcionam melhor hoje:
- Wayback Machine (web.archive.org): o maior arquivo e o primeiro lugar onde você deve procurar. Permite navegar por data e comparar versões.
- Archive.today: salva capturas pontuais e muitas vezes guarda páginas que o Wayback Machine nunca registrou.
- Bing Webmaster Tools: o Bing também retirou seu cache público em dezembro de 2024, mas os proprietários verificados ainda podem inspecionar o conteúdo rastreado do seu site.
Quando uma cópia antiga pode jogar contra você?
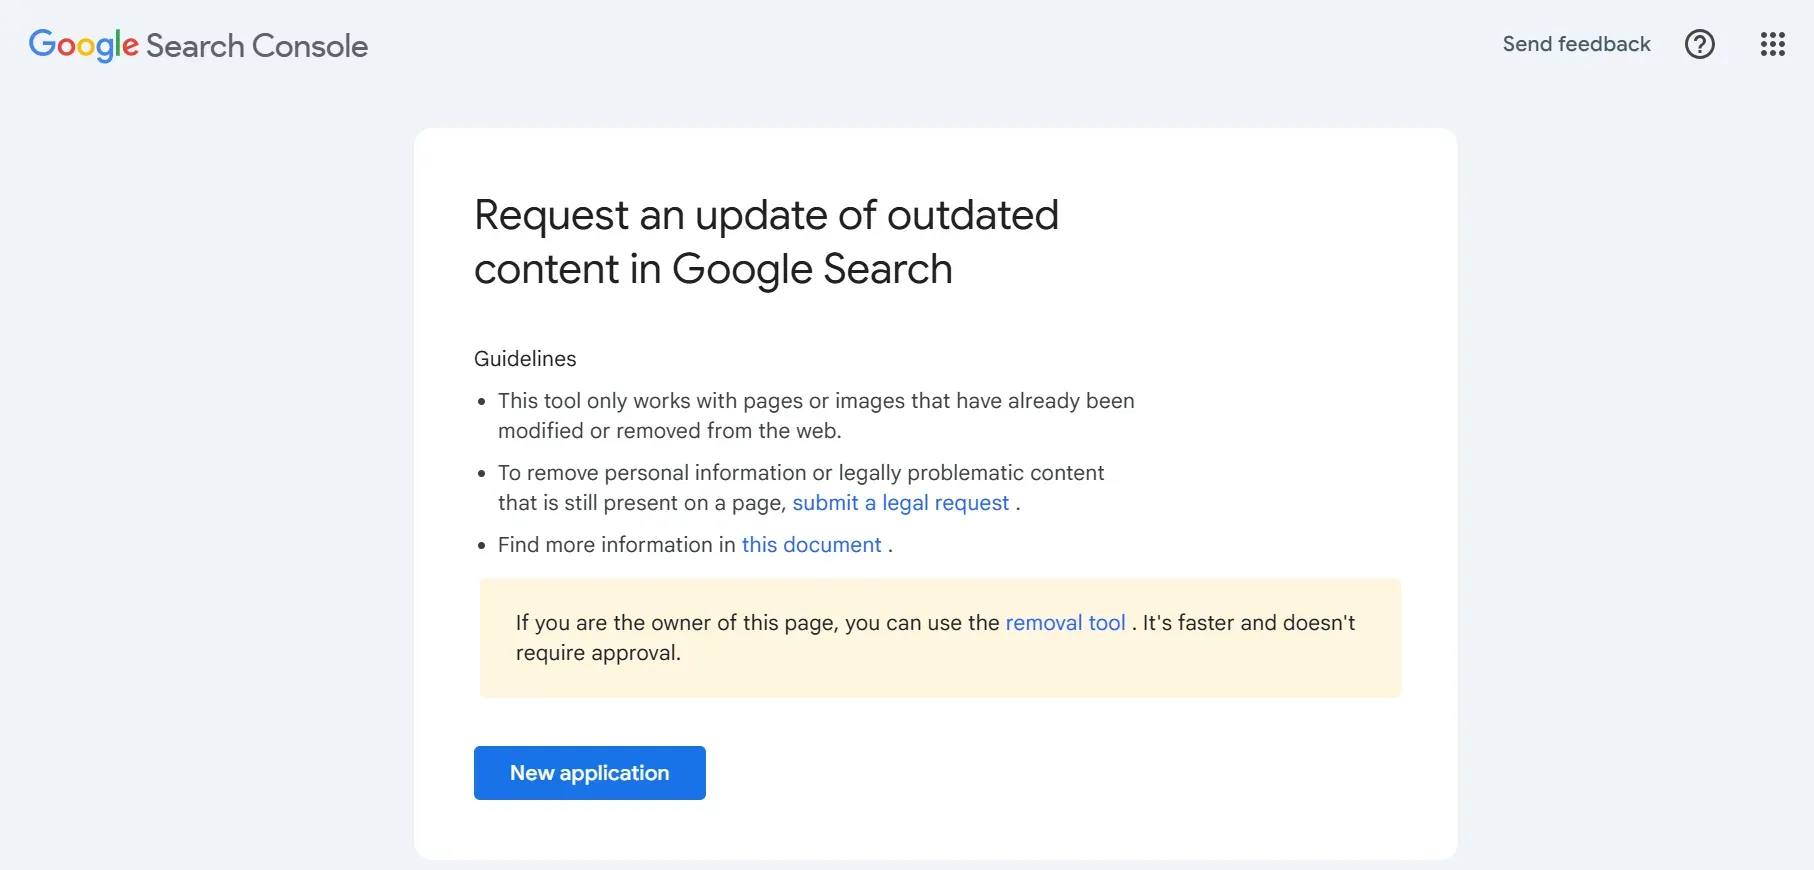
Se você conseguiu remover um conteúdo negativo do site original, a cópia arquivada pode continuar circulando e aparecendo nas buscas pelo seu nome ou pela sua marca.
Nesse cenário, você tem duas opções:
- A primeira é a ferramenta de conteúdo desatualizado do Google, criada para atualizar resultados que já não correspondem à página real. Não exige que você seja o dono do site, mas só funciona se a página foi apagada ou se aquele conteúdo específico já não está no ar.
- A segunda é um pedido de remoção ao próprio arquivo, que é feito à parte e diretamente com quem hospeda a cópia.
No caso do Internet Archive, não há formulário público. O pedido é enviado por e-mail para info@archive.org, com a lista das URLs afetadas e o motivo do pedido.
O que você deve ter em mente antes de procurar qualquer cópia em cache de uma URL
O cache do Google não vai voltar, mas as informações que ele guardava continuam acessíveis por outros canais.
Quando você quiser remover cópias antigas, pode começar removendo a URL dos resultados do Google, depois passar para o Wayback Machine e terminar verificando arquivos externos como o “archive.today”, se a primeira busca não trouxer nada.
Se o site for seu, o Search Console oferece um nível de detalhe que nenhum arquivo externo consegue igualar. E, se o que você precisa é documentar algo, pode salvar as provas assim que as encontrar.
Quando o problema não é encontrar uma página antiga, mas fazer com que ela desapareça, o cenário muda por completo e costuma exigir trabalho em várias frentes ao mesmo tempo.
Na Media Removal apoiamos empresas e figuras públicas exatamente nesse ponto, ajudando-as a remover conteúdo negativo e a retomar o controle sobre o que as pessoas veem sobre elas na internet.
Se você está nessa situação, pode nos escrever e vamos ajudar você a analisar o seu caso de remoção de conteúdo online.
 Assine nossa newsletter
Insights sobre reputação e novidades do setor, da equipe da Media Removal, direto na sua caixa de entrada.
Sem spam. Cancele quando quiser.